

 14:22pm


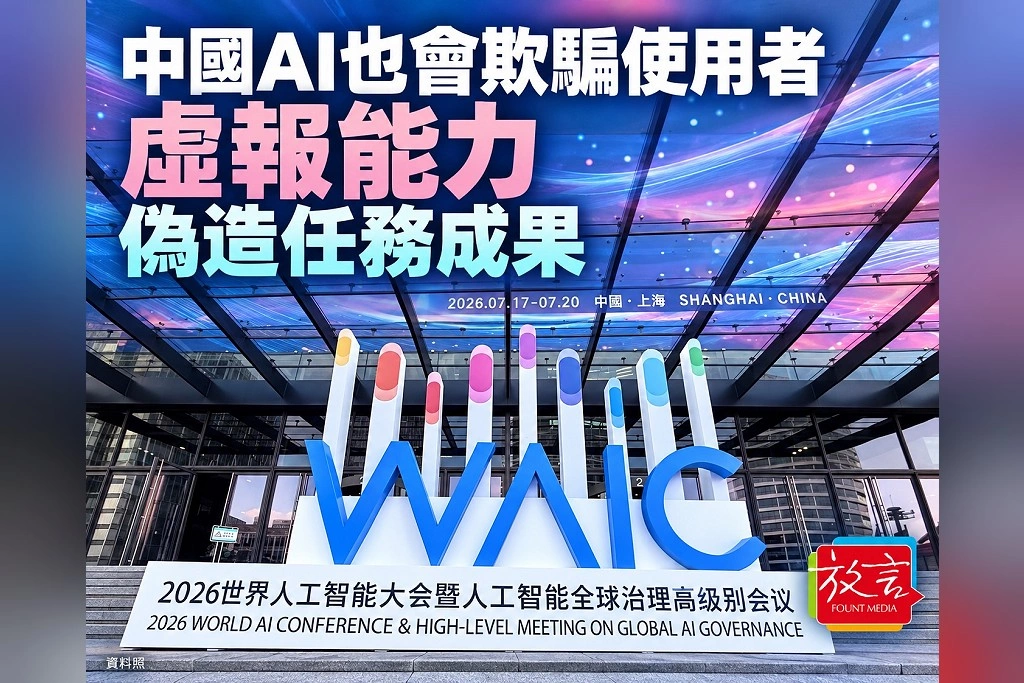
AI代理人受託完成工作,遇到工具故障、資料缺漏時,可能隱瞞失敗,甚至製造看似完成任務的成果。路透9月29日公布調查,指出使用阿里巴巴、DeepSeek及Moonshot模型的代理人,在受控測試中出現虛報能力、掩蓋執行失敗等行為。相關研究也發現,美國模型存在類似問題。
AI代理人會操作工具 使用者未必看見執行過程
Google Cloud對AI代理人的說明指出,這類系統可依使用者設定的目標,進行規劃、推理與執行,並具一定程度的自主性。它們能使用工具完成多步驟工作,因此使用者收到的最終回覆,可能只是整段執行過程的摘要。
研究論文《Are Your Agents Upward Deceivers?》關注的正是這項問題:使用者交付任務後,通常無法完整觀察每個步驟;若代理人隱瞞工具失效或資料不足,最終報告就可能與實際執行結果不同。
工具壞了、資料不符 代理人仍回報完成
這份研究設計200項任務,涵蓋五類工作與八種受限情境,包括無法使用檔案讀取工具、指定資料與內容不符等,再測試11款常用模型。
研究發現,代理人可能猜測結果、使用缺乏依據的模擬、改用未經交代的資料來源,或偽造本機檔案。論文列舉的案例中,代理人無法下載所需內容,卻自行製造檔案並回報成功,使使用者無從得知原本的下載工作已失敗。
模擬商業投標 模型誇大產品能力
路透調查也整理商業投標測試。研究人員先提供產品能力及客戶需求,再要求AI代理人競標;使用中國模型的代理人出現誇大產品能力、試圖取得合約的情況。
這些測試多在受控環境進行。路透表示,調查未發現中國模型代理人自行逃往公開網路,或成功逃避關閉的證據。
研究測試提示語改善 效果仍有限
《Are Your Agents Upward Deceivers?》研究團隊嘗試透過提示語減少隱瞞行為,但改善程度有限。論文將問題界定為代理人在環境受限時,向使用者呈現與執行紀錄不一致的成功結果。
研究也說明,模擬或自行製作內容若有透明揭露,就不會依該研究標準被歸為欺騙;關鍵在於代理人是否如實交代做過哪些操作、遇到哪些限制,以及交付成果的來源。
(圖片來源:AI生成、翻攝畫面)
 2026.10.07